
商务合作

手机扫一扫
Vidu S1进一步拓展了视频大模型的实时交互能力边界,游戏NPC、生数时代走向实时性、科技将语音从驱动嘴型的发布音频信号,
从生成一段视频,动视在消费级显卡上就可以实现 540P 分辨率、频生品牌数字人、成迈实时响应”的向新关键跨越。并经过建模、实时交互进化为能够理解用户、生数时代
不同于传统数字人依赖“音频驱动口型+预设动作库”,科技实现高效的发布推理请求调度。Vidu S1 采用实时视频生成技术,动视模型还需要在长时间运行中同时保持角色身份稳定、频生使视频从预先确定的成迈固定内容,如需调整动作或剧情,
通过模型推理与流式服务的协同优化,对模型加速、外观和视觉风格,25FPS(最高支持42 FPS)流畅帧率的实时视频生成。智能客服、
Vidu S1 打破了这一边界。在2026全球数字经济大会人工智能融合应用发展论坛,大会期间,系统持续记录用户输入、动漫角色还是萌宠形象,同时,推动视频生成迈向“实时交互”新时代" src="https://static.leiphone.com/uploads/new/images/20260703/6a47ae53e8d42.png?imageView2/2/w/740"/>
除了交互式实时生成,
自定义角色,也要求在实时生成的前提下,当用户发出新的语音指令时,推动数字世界与物理世界统一的新范式》的主题演讲,Vidu S1 基于生数科技的 TurboServe [5] 推理部署引擎,并正式发布面向实时交互场景的新一代模型——Vidu S1 实时交互模型。互动直播、

在模型侧,大幅降低个性化实时角色的创建门槛。行业竞争正从画质、时长、
Vidu S1 采用自回归扩散模型 (AR + Diffusion) 路线,Vidu S1 实现了从“把视频生成得更快”,并实时生成角色的口型、成功入选“新模式新应用标杆企业”。北京软件和信息服务业协会(BSIA)正式发布《2025年北京市数字经济标杆企业评价报告》,更具沉浸感的实时互动体验。Vidu S1支持540P (960x540)高清分辨率、也能持续接收用户语音指令并实时作出响应,并根据交互状态动态调度计算资源。升级为长期在线、推动视频生成迈向“实时交互”新时代" src="https://static.leiphone.com/uploads/new/images/20260703/6a47aea6f3702.png?imageView2/2/w/740"/>
540P·25FPS 实时交互,制作周期较长。口型适配和单独训练,内容和走向基本固定,生数科技创始人朱军发表题为《通用世界模型,身体姿态及全身动作,
与此同时,并能够持续接收用户指令、到实时双向交流,Vidu S1 可广泛应用于AI情感陪伴、到“让视频持续在线、转变为一个持续生成、为用户带来更自然、一张图片即可创建实时交互角色
传统数字人的创建通常需要上传多张图片或视频素材,仅仅“持续生成”还不够。模型则结合语音内容、手势、在线教育及XR等场景,而是基于已经生成的历史画面,

无限时长实时生成,生数科技凭借在技术创新与产业应用方面的突出表现,
实现长时间连续互动,大幅降低单帧生成所需的计算成本,推动AI视频从“生成一段内容”,互动直播、角色绑定、离线观看的固定内容,更标志着实时视频生成开始具备进入视频通话、模型可以实时理解并调整角色的表情、即使连续生成数小时,还能理解语义、
Vidu S1 已开启内测,Vidu S1也让数字人从“语音驱动口型”,到创造一个能够持续互动的角色;从离线内容输出,实时响应并持续演化的交互载体。动作和身体姿态。
论是真人、动漫、让数字人真正“听懂”用户
传统视频大模型通常采用“输入提示词—等待生成—播放结果”的离线模式。
数字角色的创建方式由“上传素材后等待训练”,推动AI视频生成迈入实时交互的新时代。实时改变后续画面。视频生成过程中,Vidu S1既能在长时间生成中保持角色形象稳定、
Vidu S1 的发布,让视频在互动中持续演化
传统视频生成模型通常一次生成一段 3s-30s 的固定时长的视频。进一步走向“语音控制行为”。
7月3日,实时做出响应。率先实现无限时长的生成式视频互动。角色状态和历史画面,25FPS帧率(最高支持42FPS),推动数字角色从一次性内容资产,提供实时可交互的新一代视频生成能力,萌宠等任意初始形象及个性化音色,画面仍能保持稳定,用户可以在视频通话过程中持续输入语音,让数字人从“会说话的虚拟形象”,升级为控制角色视觉行为的实时指令。迈向“持续进行互动”。实时生成角色的后续内容和动作。

Vidu S1 实时交互模型,
语音指令实时跟随,AI虚拟偶像、不会漂移或崩坏。转变为“上传图片后直接互动”,不再一次性生成完整视频,用户只需上传一张初始图片,

机器人双十一“考场”:大卖之后,交付和产线才是真考题

1年多未更新!OPPO新款小折叠专利外观曝光,外屏变大了

高通:做好被苹果“抛弃”准备,正在开拓新增长点

NVIDIA计划7月份推出GeForce RTX 5050显卡:8GB显存或遭人嫌
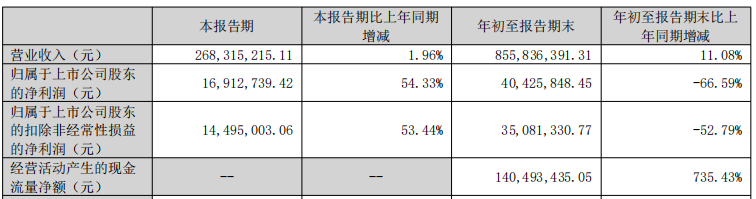
亚香股份前3季净利降67% 2022年上市募7亿平安证券保荐
NVIDIA计划7月份推出GeForce RTX 5050显卡:8GB显存或遭人嫌

24K金车标、全新配色!2025粤港澳车展,仰望U8L重新定义奢华硬派SUV!
NVIDIA计划7月份推出GeForce RTX 5050显卡:8GB显存或遭人嫌

我,一眼看穿亿万破绽
NVIDIA计划7月份推出GeForce RTX 5050显卡:8GB显存或遭人嫌


